> For the complete documentation index, see [llms.txt](https://docs.dispel.com/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.dispel.com/documentation/documentation-fr/securiser-et-gouverner/data-backup-and-recovery.md).
# Sauvegarde et restauration des données
L'approche de Dispel en matière de stockage, de conservation et de restauration des données est conçue pour offrir une sécurité robuste et une résilience opérationnelle. En utilisant une combinaison de solutions de stockage chiffrées, de mécanismes de sauvegarde automatisés et d'une redondance géographiquement distribuée, nous visons à protéger vos données contre les accès non autorisés et la perte de données. Cette documentation présente les détails techniques du fonctionnement de ces systèmes, les politiques qui les régissent et les procédures à suivre en cas de besoin de restauration des données.
## Emplacements des données
Les clients de Dispel peuvent choisir l’un de deux emplacements de résidence des données :
| Type de tableau de bord | Emplacement | Offres |
| ----------------------- | ----------- | ----------------- |
| Dispel - US | États-Unis | SaaS |
| Dispel - UE | Europe | SaaS, cloud privé |
## Sauvegarde des données
Dispel effectue des sauvegardes automatiques de toutes les données client et système afin de protéger contre les pertes catastrophiques dues à des événements imprévus affectant l'ensemble du système. Un processus automatisé sauvegardera toutes les données vers un stockage résilient face aux événements affectant une zone de disponibilité entière. Par défaut, les données sont sauvegardées au moins une fois toutes les 24 heures. Les sauvegardes sont stockées dans une archive de stockage de données chiffrée. Les sauvegardes sont surveillées et donnent lieu à des alertes.
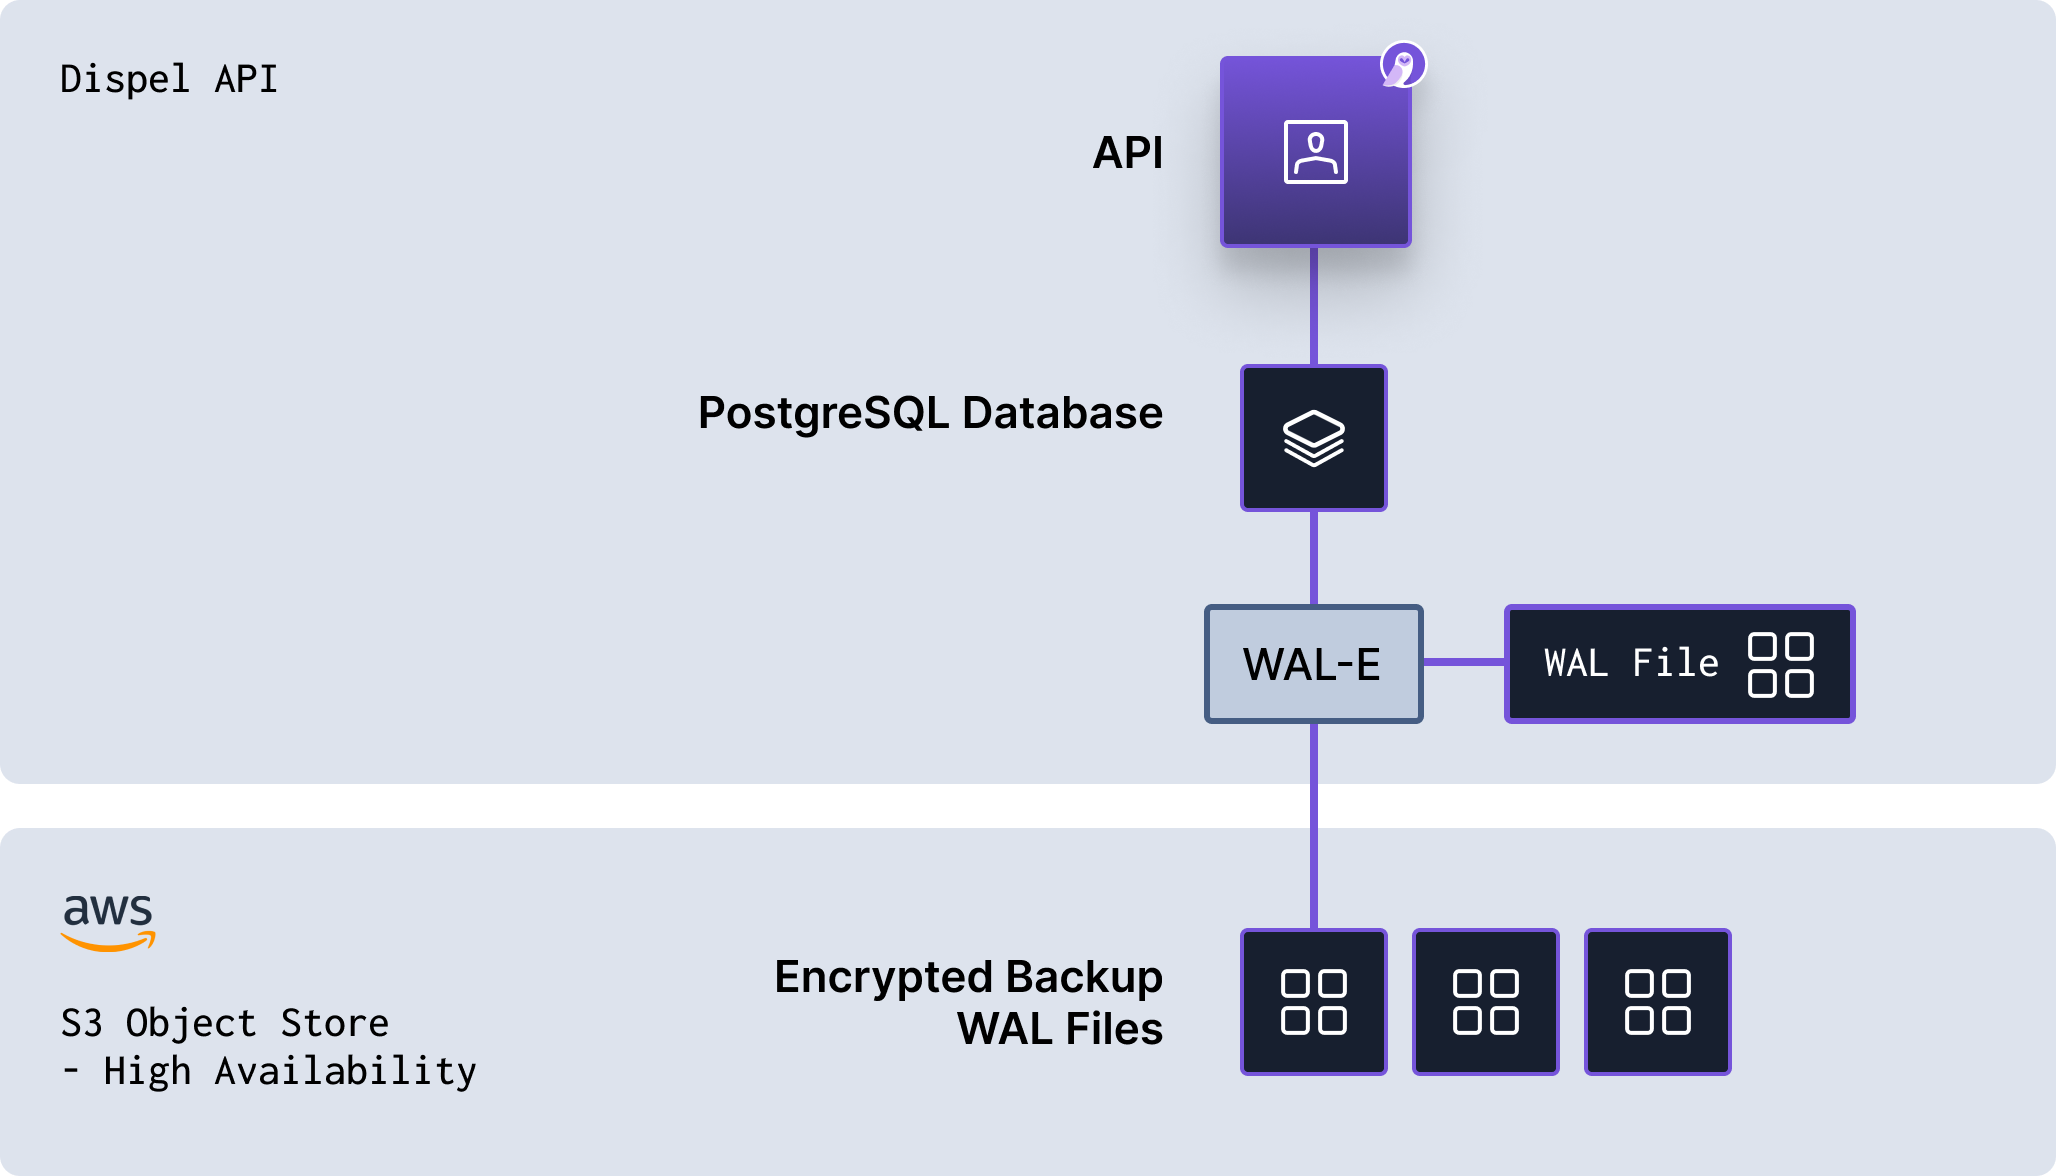
Toutes les bases de données gérées par Dispel offrent une protection continue en conservant des instantanés, des sauvegardes de base et des fichiers WAL dans le stockage d’objets. De plus, les bases de données fork et follower sont mises en œuvre en récupérant des instantanés ou des sauvegardes de base persistantes ainsi que des fichiers WAL, puis en les rejouant sur une nouvelle installation de Postgres. Le stockage de ces sauvegardes physiques dans un stockage d’objets hautement उपलब्ध permet également de restaurer des bases de données entières en cas de panne matérielle, de corruption des données ou d’interruption de service à grande échelle. Par défaut, les stockages d’objets du sous-traitant de Dispel fournissent une infrastructure durable pour stocker les données importantes et sont conçus pour une durabilité de 99,999999999 % des objets.
### Types de sauvegarde
Dispel effectue des sauvegardes complètes des bases de données. Les transactions validées dans la base de données sont enregistrées sous forme de fichiers WAL, qui peuvent être rejoués au-dessus des instantanés ou des sauvegardes de base, fournissant ainsi une méthode de reconstruction complète de l’état d’une base de données. Les instantanés sont stockés directement dans le stockage d’objets. Les sauvegardes de base et les fichiers WAL sont transférés vers le stockage d’objets via une application appelée WAL-E dès qu’ils sont mis à disposition par Postgres.
## Restauration des données
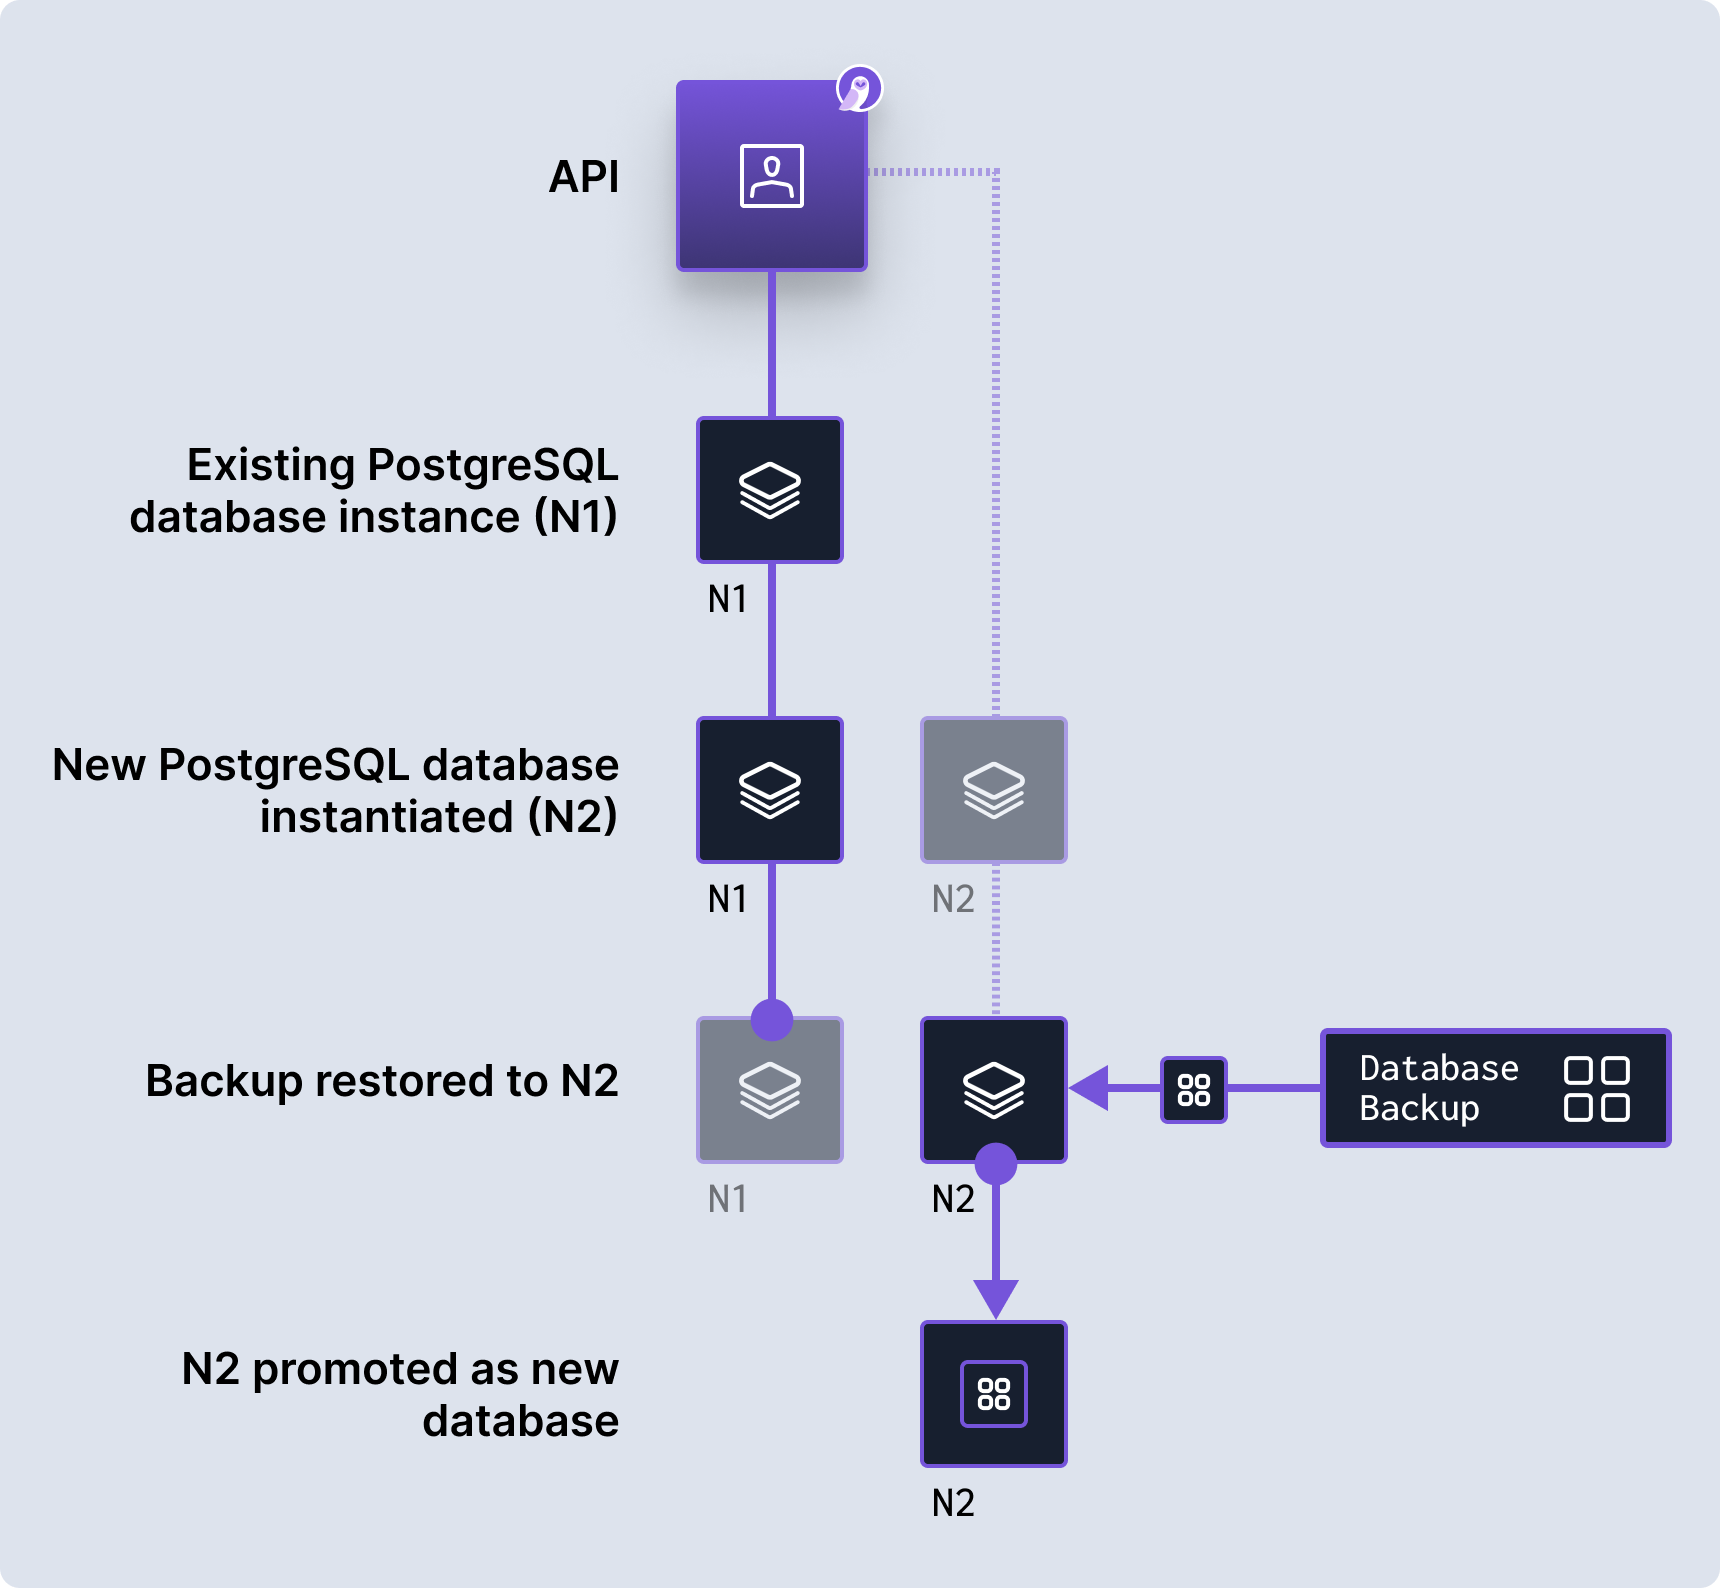
Les bases de données peuvent être restaurées à partir de sauvegardes depuis un état froid ou synchronisées avec une base de données existante. Celles-ci sont connues, respectivement, sous le nom de *fork* et *de suivi* processus. Dispel peut également revenir à une sauvegarde antérieure de la base de données.
Dans tous les cas, une nouvelle instance de base de données (N2) est créée, mise en parallèle avec la base de données existante (N1), puis promue en base de données principale pour l'API. Cela est illustré dans le schéma de processus suivant montrant une restauration des données par fork d'une base de données :
### Reprise après sinistre / Continuité d’activité
Notre plateforme restaure automatiquement les bases de données Postgres en cas de panne. La plateforme Dispel est conçue pour déployer dynamiquement des applications dans le cloud, surveiller les défaillances et rétablir les composants défaillants de la plateforme, y compris les applications et les bases de données des clients.
## Limites de conservation des sauvegardes
Les bases de données de production fonctionnent sur Amazon Aurora (RDS) avec des sauvegardes automatisées configurées sur une fenêtre de conservation glissante de 30 jours, offrant une récupération continue à un instant précis (PITR) à n’importe quelle seconde au cours des 30 derniers jours. Les sauvegardes automatisées incluent des instantanés quotidiens et des journaux de transactions stockés dans Amazon S3, le tout chiffré par KMS et avec un accès restreint aux opérateurs autorisés. Les journaux peuvent être conservés jusqu’à un an ou plus afin de répondre aux exigences de conformité, d’audit et d’enquête médico-légale.
## Exportation / archivage des données
Les clients peuvent demander une copie de leurs données pour exportation et archivage. Dispel utilise le `pg_dump` outil PostgreSQL pour créer ses fichiers de sauvegarde, ce qui facilite l’exportation vers d’autres installations PostgreSQL. Le fichier de sauvegarde résultant utilise l’option de format personnalisé dans `pg_dump`. Par rapport au format en texte brut, les options de format personnalisé peuvent produire des fichiers de sauvegarde beaucoup plus petits.
## Propriété des données
Les données des clients appartiennent aux clients ; les données de Dispel appartiennent à Dispel. Pour plus d’informations sur la manière dont Dispel traite les données client, veuillez consulter notre [Politique de confidentialité](https://legal.dispel.com/policies/privacy-policy).
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.dispel.com/documentation/documentation-fr/securiser-et-gouverner/data-backup-and-recovery.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.